به نقل از دیجیتال مارکتینگ ایران، گری ایلیس، از چهرههای شناختهشده تیم گوگل در حوزه جستوجو و خزیدن وب، هشدار داده است که گسترش هوش مصنوعی و افزایش تقاضا برای جمعآوری محتوای اینترنتی، جعل هویت رباتهای خزنده را به مسئلهای جدیتر برای مدیران وبسایتها تبدیل کرده است. به گفته او، برخی رباتهای غیرمجاز با معرفی خود بهعنوان خزندههای معتبر، از جمله Googlebot، تلاش میکنند به محتوایی دسترسی پیدا کنند که ممکن است در شرایط عادی اجازه مشاهده آن را نداشته باشند.
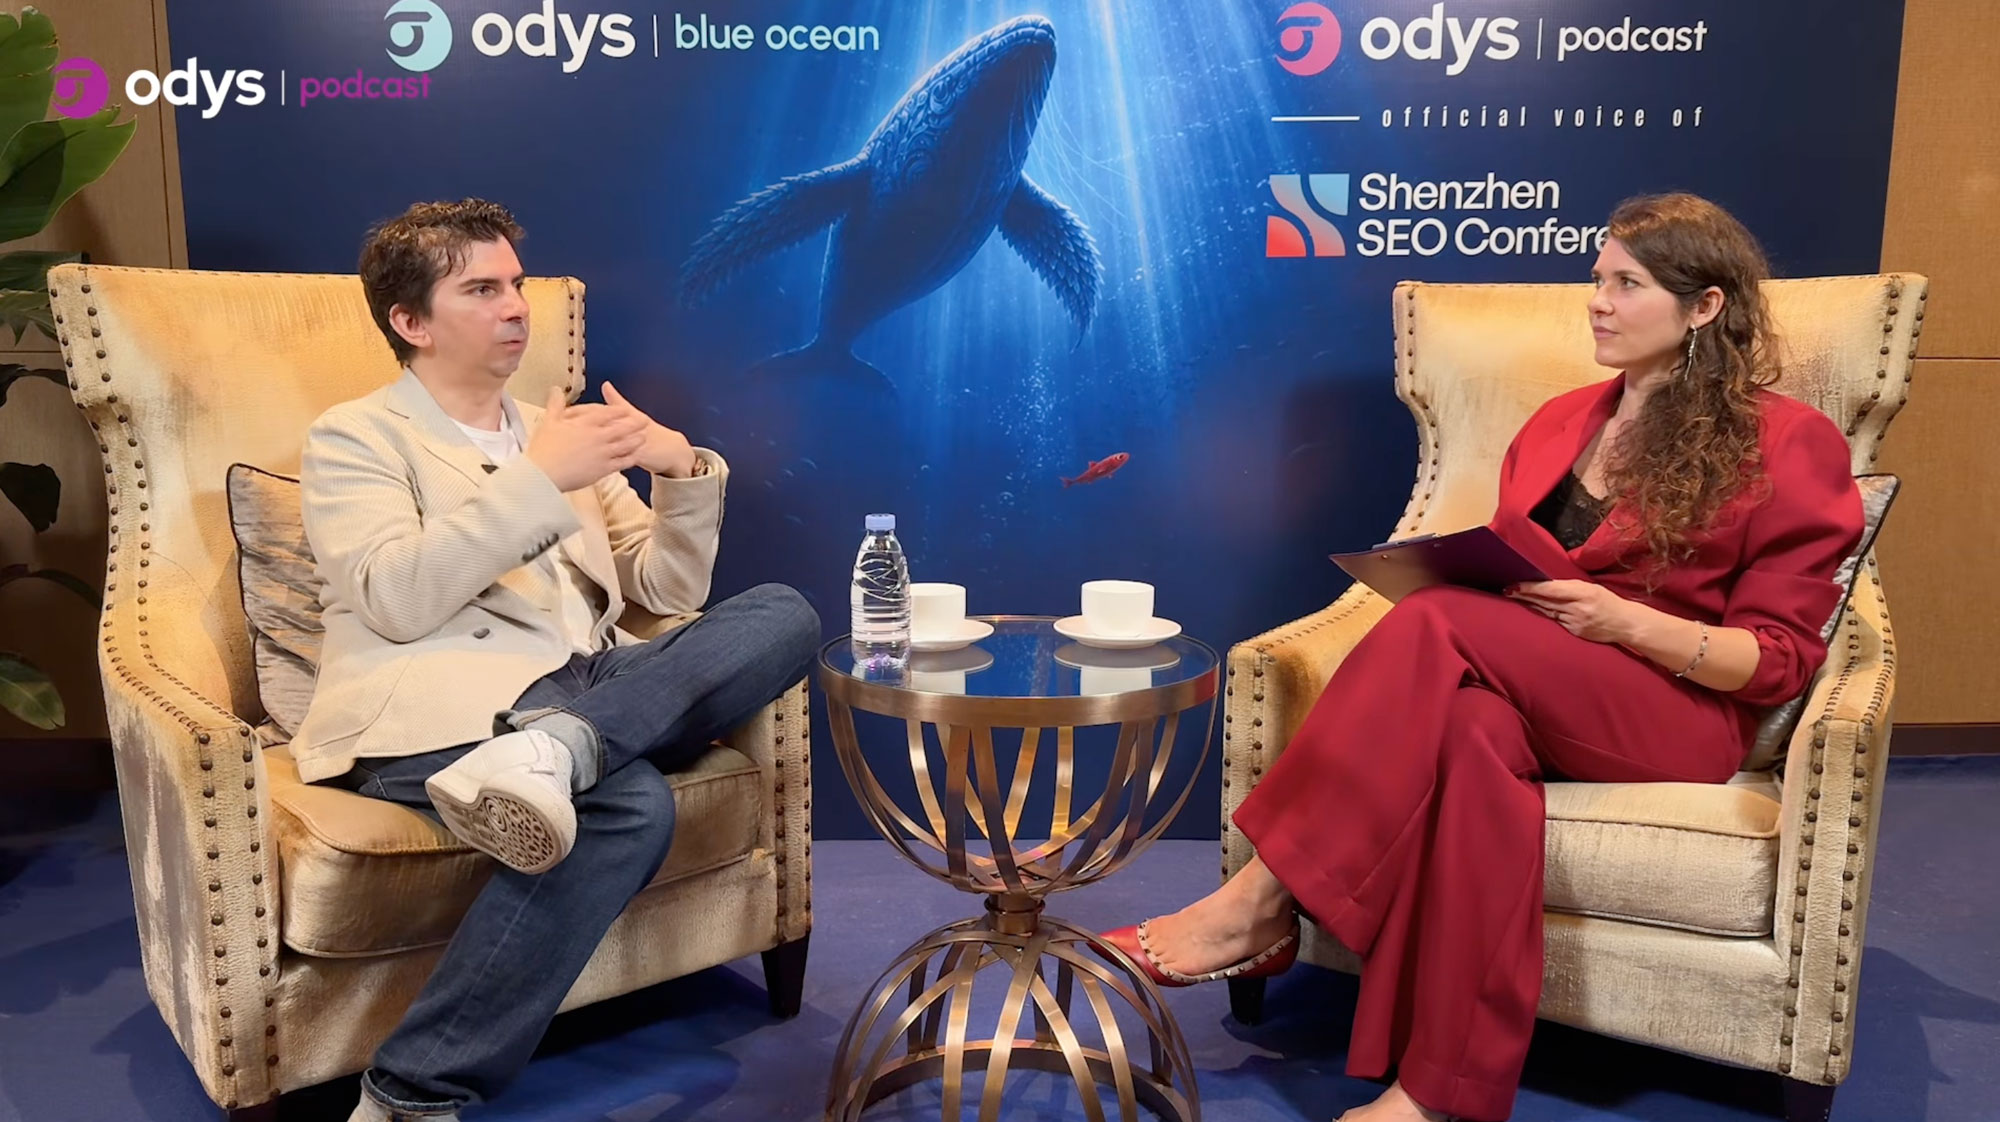
این موضوع در گفتوگوی اخیر ایلیس با آنیتا سامکوف، مجری پادکست Odys، مطرح شد. محور اصلی این مصاحبه رباتها، خزندههای موتورهای جستوجو و شیوه شناسایی درخواستهای خودکار بود. ایلیس توضیح داد که تغییر هویت ظاهری یک ربات کار دشواری نیست و وبسایتها نباید صرفاً بر اساس نامی که یک درخواست در بخش User-Agent اعلام میکند، به آن اعتماد کنند.
جعل هویت Googlebot چیست و چرا اهمیت دارد؟
هر بار که خزندهای برای بررسی صفحات به یک وبسایت درخواست ارسال میکند، معمولاً اطلاعاتی درباره نوع نرمافزار و هویت ادعایی خود در هدرهای درخواست ارائه میدهد. یکی از این اطلاعات، رشتهای به نام User-Agent است که میتواند مشخص کند درخواست ظاهراً از طرف مرورگر، ربات موتور جستوجو یا ابزار دیگری ارسال شده است.
مشکل از جایی آغاز میشود که یک ربات غیرمجاز، User-Agent خود را به شکلی تنظیم کند که شبیه Googlebot یا خزنده معتبر دیگری به نظر برسد. در این حالت، مدیر سایت ممکن است تصور کند درخواست از طرف گوگل ارسال شده و دسترسی آن را مجاز بداند؛ در حالی که فرستنده واقعی هیچ ارتباطی با گوگل ندارد.
گری ایلیس میگوید تغییر این شناسه بسیار ساده است و حتی میتوان در مدت کوتاهی یک خزنده را به شکلی تنظیم کرد که خود را Googlebot معرفی کند. او همچنین به تجربه راهاندازی تلههای اینترنتی یا Honeypot اشاره کرده است؛ محیطهایی که برای شناسایی رفتار رباتها طراحی میشوند. در این آزمایشها، درخواستهایی با هویت ادعایی Googlebot مشاهده شدهاند که از نشانیهای IP مرتبط با زیرساخت گوگل ارسال نشده بودند.
بنابراین، مشاهده عبارت Googlebot در گزارش سرور بهتنهایی اثبات نمیکند که درخواست واقعاً از سوی گوگل انجام شده است. تشخیص هویت واقعی خزنده، به بررسی اطلاعات فنی بیشتری نیاز دارد.
چرا هوش مصنوعی جعل هویت رباتها را افزایش داده است؟
به باور ایلیس، یکی از عوامل اصلی افزایش جعل هویت رباتها، رشد شرکتهایی است که برای آموزش یا بهبود مدلهای هوش مصنوعی به حجم زیادی از محتوای اینترنت نیاز دارند. این شرکتها ممکن است برای گردآوری دادههای آموزشی، صفحات وب را بهصورت خودکار جمعآوری و پردازش کنند.
از آنجا که محتوای وب برای آموزش مدلهای زبانی و دیگر سامانههای هوش مصنوعی ارزشمند است، برخی گردآورندگان داده تلاش میکنند به منابع بیشتری دسترسی پیدا کنند. اما بسیاری از وبسایتها با استفاده از فایروال، شبکه توزیع محتوا یا ابزارهای مدیریت ربات، دسترسی خزندههای ناشناس را محدود میکنند.
ایلیس توضیح میدهد که برخی رباتها ممکن است برای عبور از این محدودیتها، خود را بهجای خزندهای شناختهشده مانند Googlebot معرفی کنند. دلیل این رفتار روشن است: وبسایتی که به خزنده گوگل اجازه دسترسی میدهد، ممکن است درخواستهایی را که با همین هویت ظاهری ارسال شدهاند نیز مجاز بداند.
البته او تأکید میکند که ابزارهای امنیتی مانند فایروالها و شبکههای CDN در سالهای اخیر در شناسایی خزندههای مشکوک پیشرفت کردهاند، اما هیچکدام بینقص نیستند. در نتیجه، بخشی از ترافیکی که قرار بوده مسدود شود، همچنان میتواند از فیلترها عبور کند.
خزندههای غیراصولی چگونه میتوانند یک وبسایت را از دسترس خارج کنند؟
جعل هویت تنها مسئلهای نیست که مدیران سایت باید به آن توجه کنند. رفتار نامناسب خزندهها نیز میتواند منابع سرور را تحت فشار قرار دهد. یک ربات ممکن است در فاصله زمانی کوتاه، تعداد زیادی صفحه را درخواست کند یا یک URL را بارها و بارها بررسی کند. اگر این درخواستها کنترل نشوند، مصرف پهنای باند، پردازنده و حافظه سرور افزایش پیدا میکند.
در چنین شرایطی، وبسایت ممکن است کند شود یا حتی برای مدتی از دسترس خارج شود. این اتفاق بهویژه زمانی اهمیت دارد که منابع میزبانی محدود باشند یا خزنده بدون توجه به ظرفیت سرور، درخواستهای متوالی ارسال کند.
ایلیس اشاره میکند که گوگل طی سالها زیرساخت خزیدن خود را بهگونهای تنظیم کرده است که از وارد کردن فشار غیرضروری به وبسایتها جلوگیری کند. با این حال، همه توسعهدهندگان خزندهها چنین ملاحظاتی را رعایت نمیکنند. برخی از مشکلات ممکن است نه از حمله عمدی، بلکه از پیادهسازی ضعیف، تنظیمات اشتباه یا ناآگاهی توسعهدهندگان ناشی شوند.
به همین دلیل، مدیر سایت باید علاوه بر شناسایی هویت ربات، الگوی رفتاری آن را نیز بررسی کند. یک خزنده حتی اگر هویت واقعی خود را اعلام کند، در صورت ارسال درخواستهای بیش از حد میتواند برای زیرساخت سایت مشکلساز شود.
چرا فایل robots.txt برای مقابله با رباتهای مخرب کافی نیست؟
یکی از ابزارهای شناختهشده مدیریت دسترسی خزندهها، فایل robots.txt است. مدیران وبسایت با استفاده از این فایل میتوانند به رباتهای سازگار اعلام کنند که کدام بخشهای سایت را بررسی کنند و از دسترسی به چه مسیرهایی خودداری کنند.
با این حال، گری ایلیس یادآوری میکند که robots.txt یک سازوکار امنیتی یا محدودیت فنی اجباری نیست. این فایل بیشتر نقش مجموعهای از دستورالعملها و درخواستها را دارد. خزندههای معتبر معمولاً به آن احترام میگذارند، اما هیچ تضمینی وجود ندارد که یک ربات مخرب یا غیرمجاز نیز از این قواعد پیروی کند.
برای مثال، اگر در robots.txt دسترسی یک مسیر به رباتی ممنوع شده باشد، خزندهای که عمداً قوانین را نادیده میگیرد همچنان میتواند درخواست خود را ارسال کند. بنابراین، اتکا به این فایل برای محافظت از اطلاعات حساس یا جلوگیری قطعی از دسترسی رباتهای مخرب کافی نیست.
نقش WAF و ابزارهای امنیتی در کنترل ترافیک
برای مسدود کردن درخواستهای ناخواسته، باید از ابزارهایی استفاده کرد که در سطح شبکه و سرور امکان کنترل واقعی ترافیک را فراهم میکنند. یکی از این ابزارها WAF یا فایروال برنامههای وب است.
WAF میتواند درخواستهای ورودی را بر اساس مجموعهای از قواعد امنیتی بررسی کند و در صورت مشاهده الگوهای مشکوک، آنها را محدود یا مسدود کند. این ابزار در کنار قابلیتهای مدیریت ربات در سرویسهای CDN میتواند به شناسایی ترافیک غیرعادی و کاهش فشار روی زیرساخت کمک کند.
البته انتخاب سطح محدودیت باید با دقت انجام شود. مسدود کردن بیش از حد درخواستها ممکن است دسترسی خزندههای معتبر موتورهای جستوجو را نیز مختل کند و بر فرایند ایندکس شدن صفحات اثر بگذارد.
تفاوت Googlebot و Google-Extended چیست؟
یکی از نکات مهم مطرحشده در این گفتوگو، تفاوت میان خزیدن صفحات برای جستوجوی گوگل و استفاده از محتوا در برخی کاربردهای هوش مصنوعی است. گوگل برای این دو نوع دسترسی، سازوکارهای متفاوتی در نظر گرفته است.
Googlebot خزنده اصلی گوگل برای بررسی صفحات وب و کمک به فرایندهای مرتبط با جستوجو است. در مقابل، Google-Extended یک توکن کنترلی است که مدیران سایت میتوانند در فایل robots.txt از آن برای اعلام ترجیحات خود درباره برخی کاربردهای محتوای سایت در محصولات و مدلهای هوش مصنوعی گوگل استفاده کنند.
نکته مهم این است که Google-Extended جایگزین Googlebot نیست و کنترل مستقیم ایندکس شدن صفحات در نتایج جستوجو را بر عهده ندارد. در واقع، مدیر سایت میتواند دسترسی Googlebot برای جستوجو را مجاز نگه دارد و در عین حال، با استفاده از دستورهای مربوط به Google-Extended، برخی استفادههای واجد شرایط از محتوا برای آموزش یا بهبود مدلها و سرویسهای هوش مصنوعی گوگل را محدود کند.
ایلیس همچنین به وجود توکن مشابهی با نام Applebot-Extended اشاره کرده است. این روند نشان میدهد که مدیریت دسترسی رباتها ممکن است بهتدریج از یک سیاست کلی برای تمام خزندهها فاصله بگیرد و به کنترلهای دقیقتر بر اساس نوع فعالیت و کاربرد داده تبدیل شود.
آینده احراز هویت رباتها؛ امضای رمزنگاریشده درخواستها
یکی از راهکارهای فنی که در این گفتوگو مطرح شد، استفاده از امضاهای رمزنگاریشده برای تأیید هویت رباتهاست. این ایده با عنوان Web Bot Auth شناخته میشود و هدف آن ایجاد روشی قابلاعتمادتر برای تشخیص فرستنده واقعی درخواستهای خودکار است.
در روشهای متداول، مدیر سایت ممکن است از اطلاعاتی مانند User-Agent، نشانی IP و بررسی معکوس DNS برای تشخیص خزنده استفاده کند. اما هر یک از این روشها محدودیتهایی دارند. برای نمونه، User-Agent بهآسانی قابل جعل است و مدیریت فهرستهای IP نیز با گسترش زیرساختهای ابری و تغییرات شبکه میتواند پیچیدهتر شود.
در رویکرد مبتنی بر امضای رمزنگاریشده، درخواست HTTP میتواند همراه با امضایی ارسال شود که با کلید عمومی سازمان ادعاشده قابل بررسی باشد. وبسایت دریافتکننده با اعتبارسنجی این امضا میتواند اطمینان بیشتری درباره منشأ درخواست به دست آورد.
چنین سازوکاری در صورت توسعه و پذیرش گسترده میتواند وابستگی احراز هویت به رشته User-Agent یا فهرستهای IP را کاهش دهد. البته موفقیت آن به استانداردسازی، پشتیبانی زیرساختها و همکاری ارائهدهندگان خزندهها و سرویسهای امنیتی بستگی خواهد داشت.
آیا سیستم اعتبارسنجی و امتیازدهی به رباتها در راه است؟
گری ایلیس از ایده دیگری نیز صحبت کرده است: ایجاد نوعی سیستم اعتبار یا شهرت برای خزندههای اینترنتی. در چنین مدلی، رفتار رباتها میتواند بر اساس بازخورد وبسایتها و ارائهدهندگان خدمات امنیتی ارزیابی شود.
برای مثال، اگر یک خزنده بهطور منظم قوانین دسترسی را رعایت کند، درخواستهای خود را در سطح معقول نگه دارد و به منابع سرور فشار غیرضروری وارد نکند، میتواند از اعتبار بالاتری برخوردار شود. در مقابل، خزندههایی که رفتار نامناسب دارند یا محدودیتهای اعلامشده را نادیده میگیرند، ممکن است اعتبار کمتری دریافت کنند.
با این حال، این ایده هنوز در مراحل اولیه بررسی قرار دارد و ایلیس درباره چالشهای آن نیز هشدار داده است. اگر کنترل چنین سیستمی در اختیار یک شرکت واحد باشد، احتمال ایجاد سوگیری یا ترجیح دادن خزندههای متعلق به همان شرکت وجود خواهد داشت. بنابراین، طراحی یک نظام اعتبارسنجی قابلاعتماد به سازوکار شفاف و مشارکت چندجانبه نیاز دارد.
مدیران وبسایتها چگونه از خود در برابر رباتهای جعلی محافظت کنند؟
با توجه به نکات مطرحشده از سوی ایلیس، مدیران سایتها میتوانند چند اقدام عملی را برای مدیریت بهتر ترافیک خودکار در نظر بگیرند. میزان پیچیدگی این اقدامات باید متناسب با اندازه سایت، حجم بازدید و شدت مشکلات مشاهدهشده باشد.
۱. هویت Googlebot را فقط با User-Agent تأیید نکنید
اگر در گزارش سرور درخواستی با شناسه Googlebot مشاهده کردید، آن را بهتنهایی معتبر در نظر نگیرید. برای بررسی درخواستهای منتسب به گوگل، از روشهای رسمی تأیید استفاده کنید. بررسی Reverse DNS و تطبیق نشانی IP با محدودههای منتشرشده از سوی گوگل، از جمله روشهای توصیهشده برای این کار هستند.
۲. گزارشهای سرور را بهصورت منظم بررسی کنید
افزایش ناگهانی تعداد درخواستها، تکرار بیش از اندازه یک URL، مراجعه مداوم از IPهای ناشناس و الگوهای غیرعادی خزیدن میتوانند نشانه فعالیت یک ربات نامناسب باشند. بررسی لاگهای سرور به شناسایی زودهنگام این رفتارها کمک میکند.
۳. در صورت نیاز از CDN و WAF استفاده کنید
اگر ترافیک خودکار باعث کندی سایت یا مصرف غیرعادی منابع میشود، استفاده از سرویس CDN دارای قابلیت مدیریت ربات یا یک WAF میتواند راهکار مناسبی باشد. این ابزارها امکان اعمال محدودیتهای دقیقتر را فراهم میکنند.
۴. فایل robots.txt را درست تنظیم کنید
دستورهای robots.txt باید با دقت و متناسب با سیاست دسترسی سایت نوشته شوند. با این حال، مدیران باید به یاد داشته باشند که این فایل فقط برای خزندههایی مؤثر است که به قواعد آن احترام میگذارند و نباید از آن بهعنوان جایگزین کنترلهای امنیتی استفاده کنند.
۵. دسترسی جستوجو و استفاده هوش مصنوعی را جداگانه مدیریت کنید
اگر سیاست محتوایی سایت اجازه میدهد صفحات در نتایج جستوجو نمایش داده شوند، اما مدیر سایت درباره استفاده از آنها در برخی کاربردهای هوش مصنوعی محدودیتهایی دارد، باید توکنها و دستورالعملهای مخصوص هر سرویس را بررسی کند. Google-Extended نمونهای از این تفکیک است؛ البته این ابزار بهمعنای جلوگیری از تمام روشهای احتمالی جمعآوری محتوا توسط اشخاص ثالث نیست.
آیا همه وبسایتها به ابزارهای پیشرفته مقابله با ربات نیاز دارند؟
ایلیس معتقد است مدیران سایتهای کوچک نباید بدون مشاهده نشانهای از مشکل، فوراً به سراغ راهکارهای پیچیده و پرهزینه بروند. نخستین قدم، بررسی میزان ترافیک رباتها و شناسایی تأثیر واقعی آنها بر عملکرد سایت است.
اگر یک وبسایت کوچک با درخواستهای غیرعادی مواجه نیست و منابع سرور آن تحت فشار قرار نمیگیرد، ممکن است تنظیمات پایه و امکانات امنیتی سرویس میزبانی برای شروع کافی باشند. در مقابل، وبسایتهای بزرگتر و پربازدید که حجم زیادی از درخواستهای خودکار دریافت میکنند، ممکن است به ابزارهای پیشرفتهتر مدیریت ربات نیاز داشته باشند.
او همچنین اشاره کرده است که برخی پلتفرمهای میزبانیشده، مانند Shopify، بخشی از امکانات محافظتی را در زیرساخت خود ارائه میکنند. در نتیجه، میزان مسئولیت مدیر سایت برای پیادهسازی این ابزارها به نوع پلتفرم و خدمات میزبانی نیز بستگی دارد.
جمعبندی؛ مدیریت رباتها به بخش مهمتری از سئو تکنیکال تبدیل میشود
هشدار گری ایلیس نشان میدهد که رشد هوش مصنوعی فقط شیوه تولید و مصرف محتوا را تغییر نداده، بلکه چالشهای تازهای را برای زیرساخت وب و مدیریت دسترسی به اطلاعات ایجاد کرده است. افزایش تقاضا برای دادههای اینترنتی میتواند انگیزه بیشتری برای ساخت خزندهها و جمعآوری خودکار محتوا ایجاد کند؛ در این میان، جعل هویت رباتهای معتبر و ارسال درخواستهای کنترلنشده از جمله تهدیدهایی هستند که مدیران سایت باید آنها را جدی بگیرند.
برای صاحبان وبسایتها، مهمترین نکته این است که نباید به User-Agent اعتماد کامل داشته باشند و باید هویت خزندهها را با روشهای فنی معتبر بررسی کنند. همچنین robots.txt ابزار مناسبی برای اعلام ترجیحات دسترسی است، اما جایگزین فایروال و کنترلهای امنیتی نیست. ترکیب پایش لاگها، احراز هویت خزندهها، CDN و WAF میتواند به مدیریت بهتر ترافیک رباتها کمک کند.
در نهایت، با گسترش جستوجوی هوش مصنوعی و افزایش استفاده از محتوای وب برای آموزش مدلها، تفکیک دسترسی خزندهها بر اساس نوع کاربرد اهمیت بیشتری پیدا خواهد کرد. برای دنبال کردن تازهترین خبرها و تحلیلهای مرتبط با گوگل، سئو تکنیکال و تأثیر هوش مصنوعی بر وب، به دیجیتال مارکتینگ ایران مراجعه کنید.
“`